로컬 LLM 장비 추천 2026 — VRAM이 전부, R9700 32GB·RTX 5080·5090·ASUS GX10 비교
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
로컬 LLM 장비 추천을 VRAM 기준으로 정리했습니다. 모델 총 가중치가 VRAM에 통째로 올라가느냐가 속도를 가르고, Q4 기준 필요 메모리는 대략 총 파라미터÷2GB입니다. 27~32B급 에이전트 입문은 32GB 라데온 AI PRO R9700(274.9만~), 16GB RTX 5080(235만~)은 20B 이하, 70B 이상 대형 모델은 128GB 통합 메모리 ASUS Ascent GX10(937.9만~)이 기준입니다.
📊 스펙 요약
| 그래픽카드 | |
|---|---|
| ASRock 라데온 AI PRO R9700 Creator 32GB | VRAM 32GB GDDR6 · 대역폭 640GB/s · 블로워팬 · 750W 이상 권장 · 2,749,000원 |
| GIGABYTE 라데온 AI PRO R9700 AI TOP 32GB | VRAM 32GB · 640GB/s · 블로워팬 · 리뷰 4 ★5.0 · 2,885,200원 |
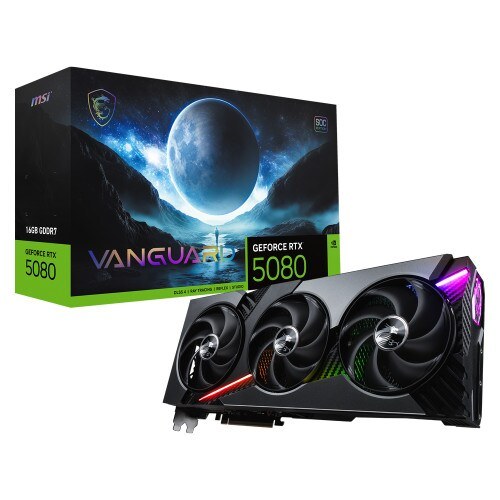
| MSI 지포스 RTX 5080 뱅가드 16GB | VRAM 16GB GDDR7 · 960GB/s · 850W 이상 · 리뷰 112 ★4.9 · 2,578,990원 |
| COLORFUL iGame RTX 5080 ULTRA OC 16GB | VRAM 16GB · 960GB/s · 2,350,000원 |
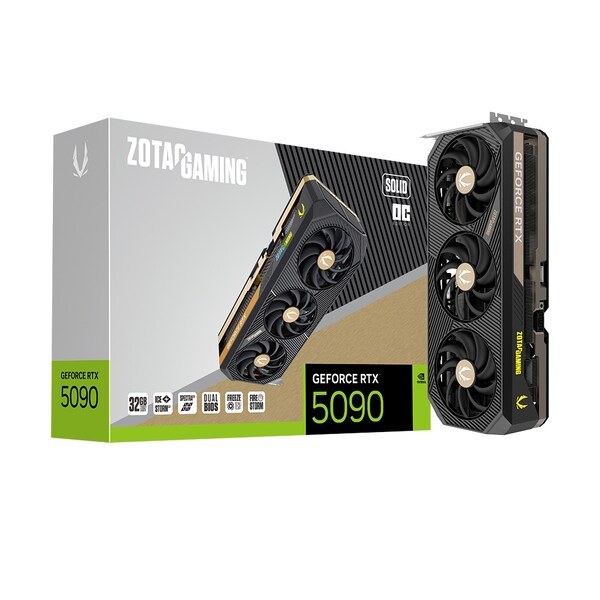
| ZOTAC RTX 5090 SOLID OC 32GB | VRAM 32GB GDDR7 · 1,792GB/s · 1000W 이상 · 8,839,650원 |
| AI 미니PC | |
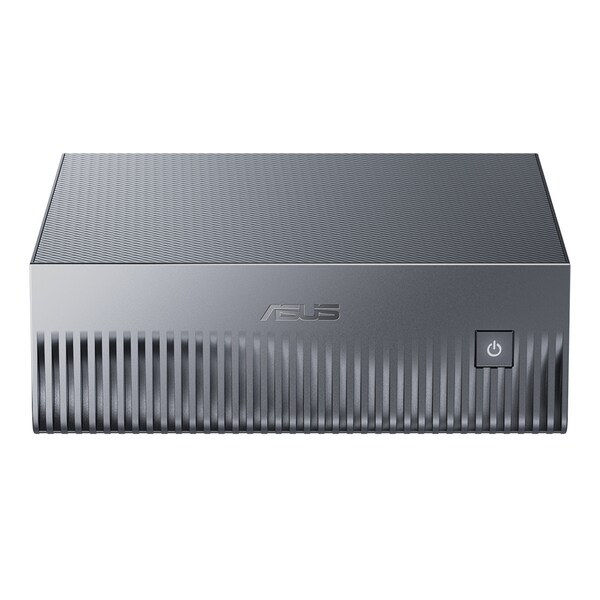
| ASUS Ascent GX10 1TB | NVIDIA GB10 · 통합 메모리 128GB LPDDR5X · 10Gbps 유선 · 와이파이 7 · 9,378,580원 |
| 참고 | |
| 가격은 2026년 9월 29일 다나와 등록가 · 메모리 품귀로 시세 변동 큼 · 필요 메모리는 Q4 양자화 기준 어림값 | |
한눈에 보는 장단점
✅ 좋았던 점
- 라데온 AI PRO R9700은 RTX 5080보다 조금 더 주고 VRAM이 두 배(32GB)라 27~32B급 모델을 GPU에 통째로 올려 에이전트 작업까지 돌릴 수 있습니다
- 32GB VRAM이면 Qwen 3.6 27B·35B 같은 모델이 GPU에서 100% 처리돼 초당 수십 토큰으로 실시간 대화가 됩니다
- ASUS Ascent GX10은 128GB 통합 메모리로 그래픽카드 한 장으로는 안 올라가는 70B~100B급 모델도 집에서 올릴 수 있습니다
❌ 아쉬운 점
- RTX 5080(16GB)은 추론 속도는 빠르지만 20B·32B급 모델이 VRAM에 다 안 올라가 로컬 LLM용으로는 한계가 빨리 옵니다
- VRAM을 넘겨 CPU로 넘어가는 순간 속도가 초당 4토큰대로 폭락해, 모델 크기를 VRAM에 맞추지 않으면 체감이 크게 나빠집니다
- R9700은 블로워팬이라 부하가 걸리면 소음이 크고, GX10은 900만 원대로 입문용 가격이 아닙니다
로컬 LLM 장비 추천에서 돈을 결정하는 변수는 딱 하나, VRAM(그래픽카드 메모리)입니다. 모델의 총 가중치가 VRAM에 통째로 올라가느냐에 따라 속도가 수십 배 차이 납니다. CPU가 좋고 코어가 많아도, 모델이 VRAM을 넘치는 순간 체감 속도가 무너집니다. 그래서 장비를 고르는 순서도 ① VRAM → ② 시스템 메모리 → ③ 그래픽카드 대역폭 → ④ CPU입니다. 32GB 그래픽카드로 실제 모델들을 돌린 결과를 바탕으로, 어느 등급에서 무엇이 되는지 정리했습니다.
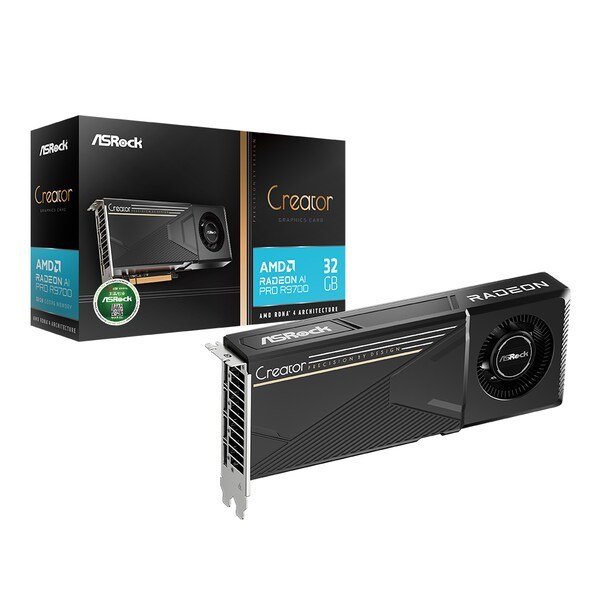
한눈에 — 예산·목적별 장비
| 목적 | 추천 | VRAM·메모리 | 다나와 가격 |
|---|---|---|---|
| 요약·번역·가벼운 모델(~14B) | RTX 5080급 16GB | 16GB | 235만~ |
| 에이전트 입문(27~35B) | 라데온 AI PRO R9700 | 32GB | 274.9만~ |
| 32GB + 최고 속도 | RTX 5090 | 32GB | 884만~ |
| 70B~100B급 대형 모델 | ASUS Ascent GX10 | 128GB 통합 | 937.9만~ |
먼저 공식 하나 — 필요 메모리 ≈ 총 파라미터 ÷ 2
모델 이름의 B는 파라미터 개수(8B = 80억 개)입니다. 보통 로컬에서는 Q4 양자화(사진을 JPG로 압축하듯 정밀도를 낮춰 용량을 약 1/4로 줄임)로 돌리는데, 이때 필요한 메모리는 대략 총 파라미터 ÷ 2 GB입니다.
| 모델 크기 | 필요 메모리(Q4, 어림) | 16GB | 32GB | 128GB |
|---|---|---|---|---|
| 4~8B | 2~5GB | 여유 | 여유 | 여유 |
| 14B | 약 7~10GB | 가능 | 여유 | 여유 |
| 27~32B | 약 17~20GB | 불가 | 가능 | 여유 |
| 70B | 약 42GB | 불가 | 불가(CPU 오프로드) | 가능 |
| 109B급 | 55GB 이상 | 불가 | 불가 | 가능 |
여기에 대화 기억 공간(KV 캐시)이 가중치를 올리고 남은 메모리 안에 들어가야 합니다. 같은 64K 토큰이라도 모델에 따라 3GB에서 10GB 넘게 먹습니다. 그래서 총 가중치가 VRAM의 70% 이하인 모델을 고르는 게 안전합니다.
절벽 구간 — VRAM을 넘으면 이렇게 된다
32GB 카드에서 실제로 측정하면 차이가 극명합니다.
| 모델 | 구조 | 속도 | 비고 |
|---|---|---|---|
| Qwen3 4B | Dense | 초당 약 125토큰 | 가벼움 |
| Qwen3 30B A3B | MoE | 초당 약 96토큰 | 18~20GB, GPU 100% |
| Qwen3 32B | Dense | 초당 약 24토큰 | 같은 크기인데 MoE보다 4배 느림 |
| 70B급 | Dense | 초당 약 4.2토큰 | 42GB 필요 → 32GB 초과, CPU 오프로드 |
27~32B급까지는 GPU에서 100% 처리되지만, 70B는 VRAM을 넘는 순간 초당 4토큰대로 폭락합니다. 이게 16GB냐 32GB냐를 갈라야 하는 이유입니다. 초당 수십 토큰이면 실시간 대화에 충분하고, 초당 50토큰이면 사람이 빠르게 말하는 것보다 빠릅니다.
MoE 함정 — 속도는 활성, 메모리는 총 파라미터
MoE(전문가 혼합) 모델은 질문마다 일부 파라미터만 쓰니 빠릅니다. 하지만 어떤 파라미터를 쓸지 미리 모르기 때문에 전체를 VRAM에 올려야 합니다. 예를 들어 활성 17B짜리 모델이라도 총 파라미터가 109B면 32GB에 안 올라갑니다. 속도는 활성 파라미터가, 메모리는 총 파라미터가 정한다고 기억하세요.
그래픽카드 비교 — 왜 R9700 32GB인가
| 항목 | 라데온 AI PRO R9700 | RTX 5080 | RTX 5090 |
|---|---|---|---|
| VRAM | 32GB GDDR6 | 16GB GDDR7 | 32GB GDDR7 |
| 대역폭 | 640GB/s | 960GB/s | 1,792GB/s |
| 권장 파워 | 750W 이상 | 850W 이상 | 1000W 이상 |
| 다나와 최저가 | 274.9만 원~ | 235만 원~ | 884만 원~ |
| 27~32B 모델 | GPU에 통째로 | 안 올라감 | GPU에 통째로 |
- RTX 5080보다 조금 비싸고 VRAM은 두 배입니다. 5080은 추론이 빠르지만 20B·32B급이 안 올라가 로컬 LLM용으로는 금방 막힙니다.
- 32GB급 소비자형 카드 중 가장 저렴합니다. 지금 체감 성능이 좋은 오픈웨이트(Gemma 4 26~31B, Qwen 3.6 27·35B)를 Q4로 긴 컨텍스트까지 올리면 딱 32GB가 필요합니다.
- 추론은 학습과 다릅니다. 학습은 연산력 싸움이지만 추론은 VRAM 용량과 가격이 더 중요합니다. R9700의 추론 속도는 5080의 약 85~90% 수준이지만, 5080이 못 올리는 모델을 올립니다.
- RTX 5090 한 장 값이면 R9700 두 장을 사고 남아 VRAM 64GB 구성도 계산상 가능합니다(두 장 구성은 원 테스트에서 실측되지 않았습니다).
- 게이밍용 라데온 9070 XT와 같은 칩이라 게임도 잘 돌아갑니다.
등급별로 실제로 되는 일
| VRAM | 되는 일 | 에이전트 수준 |
|---|---|---|
| 16~24GB | 요약·번역·분류, 단발 도구 호출 | 사람이 지켜보며 도구 한두 번 호출 |
| 32GB | 27~35B 모델, 코드 작성→실행→테스트→수정까지 자율 완주 | 실용적 에이전트 |
| 48GB 이상 | 더 긴 대화·많은 턴 | 장시간 멀티턴(추정) |
| 128GB 통합 | 70B~100B급 모델 | 대형 모델 로컬 운용 |
32GB 카드에서 에이전트(웹 검색 → 보고서 작성·저장 → 원인 분석 보강) 멀티턴 테스트를 돌려 보면 모델별로 결과가 크게 갈립니다.
| 모델 | 속도(원샷) | 멀티턴 결과 |
|---|---|---|
| Qwen 3.6 35B A3B(MoE) | 초당 약 82토큰 | 완주, 약 6분 — 가장 균형 좋음(간헐적 생각 폭주는 있음) |
| Qwen 3.6 27B(Dense) | 초당 약 29토큰 | 완주, 약 10분 — 한글·도구 사용·재시도가 안정적 |
| Qwen3 30B A3B(MoE) | 초당 약 89토큰 | 완주, 첫 보고를 영어로 작성 |
| GPT-OSS 20B | 매우 빠름 | 완주 약 2분, 대신 내용이 단출 |
| Gemma 4 31B | 초당 약 23토큰 | 컨텍스트 49K라 에이전트 연결 불가, 일반 대화용 |
| GLM 4.7 Flash 30B | 초당 약 63토큰 | 검색 실패를 못 넘기고 중단 |
| 한국어 특화 모델(EXAONE 4.1 32B 등) | 초당 약 25토큰 | 한국어 원샷 품질은 좋지만 도구 호출이 안 돼 에이전트 부적합 |
교훈 두 가지: 최신 모델이라고, 벤치마크 1위라고 실전 1위가 아닙니다. 끝까지 일을 해내는지 봐야 합니다. 그리고 라이선스를 먼저 확인하세요. 회사 업무에 쓰려면 상업 이용이 자유로운 모델(예: Apache 라이선스인 Qwen 3.6)을 고르는 게 안전합니다. 일부 한국어 특화 모델은 비상업 라이선스입니다.
128GB가 필요하면 — ASUS Ascent GX10
그래픽카드 한 장(32GB)으로는 70B 이상이 안 올라갑니다. 이때 선택지가 ASUS Ascent GX10 같은 AI 미니PC입니다. 맥미니만 한 크기에 엔비디아 GB10 칩과 128GB 통합 메모리(LPDDR5X)를 넣어, 대형 모델을 집에서 오프라인으로 돌릴 수 있습니다. 10Gbps 유선랜, 와이파이 7, 리눅스 기반이고 다나와 기준 937만 8,580원(1TB)부터입니다.
- 장점: 데이터가 밖으로 안 나가 보안 걱정이 없고, 장기적으로 API 비용을 줄이고, 원하는 대로 튜닝할 수 있습니다.
- 알아둘 점: 통합 메모리 128GB도 운영체제 몫을 빼면 실제로 쓸 수 있는 양은 그보다 적습니다. 모델별 생성 속도는 메모리 대역폭에 달려 있으니, 구매 전 원하는 모델의 실측 리뷰를 확인하세요.
- 대안: 맥 쪽이라면 128GB 이상 통합 메모리의 맥 스튜디오가 비슷한 역할을 합니다(M5 Ultra 메모리 대역폭과 로컬 AI). 맥미니로 로컬 AI를 할 때 구성 고르는 법은 맥미니 구성 추천 2026에 정리했습니다.
노트북·미니PC로는 안 될까
일반적인 노트북이나 사무용 미니PC로는 만족스러운 로컬 LLM 속도를 기대하기 어렵습니다. 작은 모델(4~8B)로 요약·번역 정도는 되지만, 에이전트 작업은 VRAM 32GB급 데스크톱이나 128GB 통합 메모리 기기가 필요합니다. 사무용이라면 사무용 미니PC 사도 되나, 게임까지 겸한 노트북이라면 게이밍 노트북 추천 2026을 참고하세요.
로컬 LLM으로 되는 일, 안 되는 일
- ✅ 되는 일: 요약, 번역, 정보 추출, 분류, 내 문서 검색 답변(RAG), 코딩 보조, 짧은 에이전트 작업
- ⚠️ 한계: 긴 멀티턴은 컨텍스트가 찰수록 느려지고 성능이 떨어집니다. 같은 작업을 클라우드 최신 모델보다 약 2배 오래 걸린다고 보면 됩니다.
- ❌ 안 되는 일: 109B급 이상을 32GB 한 장으로 돌리기
- 📌 기대치: "유능한 인턴 한 명" 정도. 어려운 추론은 클라우드 모델, 민감하거나 반복적인 일은 로컬로 나누는 하이브리드가 현실적입니다.
같이 챙길 것
- 파워서플라이 — R9700 750W, RTX 5080 850W, RTX 5090 1000W 이상 권장입니다.
- 시스템 메모리 — VRAM을 넘칠 때를 대비해 넉넉하게. 다만 오프로드가 걸리면 느려지는 건 피할 수 없습니다.
- 설치 공간과 소음 — R9700은 블로워팬이라 부하 시 소음이 큽니다. 24시간 켜 둘 거면 소음이 처리되는 공간이 좋습니다.
- 소프트웨어 — LM Studio는 OpenAI 호환 API 서버를 내장해 에이전트 도구를 바로 붙일 수 있고, Ollama와 같은 GGUF 모델 파일을 공유합니다.
예산별 한 줄 추천
| 예산(그래픽카드 기준) | 추천 | 이유 |
|---|---|---|
| 235만 원~ | RTX 5080 16GB | 14B 이하, 게임 겸용 |
| 275만 원~ | 라데온 AI PRO R9700 32GB | 27~35B 에이전트 입문 |
| 884만 원~ | RTX 5090 32GB | 같은 32GB에 최고 속도 |
| 938만 원~(완제품) | ASUS Ascent GX10 | 70B 이상 대형 모델 |
사기 전 체크리스트
- [ ] 돌리고 싶은 모델의 총 파라미터를 확인하고 ÷2로 필요 메모리를 계산했다
- [ ] 총 가중치가 VRAM의 70% 이하인지 봤다(KV 캐시 여유)
- [ ] MoE 모델은 활성이 아니라 총 파라미터로 메모리를 계산했다
- [ ] 쓰려는 모델의 라이선스(상업 이용 여부)를 확인했다
- [ ] 파워서플라이 용량과 소음 대책을 준비했다
자주 하는 실수
- CPU·코어 수부터 보기 — 순서는 VRAM이 먼저입니다.
- 16GB로 32B 모델 도전 — CPU로 넘어가 초당 몇 토큰으로 떨어집니다.
- MoE 활성 파라미터만 보고 구매 — 메모리는 총 파라미터 기준입니다.
- 벤치마크 1위 모델만 믿기 — 도구 호출·멀티턴 완주 여부를 직접 확인하세요.
- 라이선스 확인 안 함 — 비상업 모델은 회사 업무에 못 씁니다.
FAQ
로컬 LLM용 그래픽카드는 VRAM 몇 GB가 필요한가요? 요약·번역 위주면 16GB, 27~35B급 모델로 에이전트 작업까지 하려면 32GB가 기준입니다.
RTX 5080과 R9700 중 뭐가 낫나요? 로컬 LLM만 보면 VRAM이 두 배인 R9700(32GB)입니다. 추론 속도는 5080의 85~90% 수준이지만 5080이 못 올리는 모델을 올립니다.
70B 모델을 집에서 돌리려면? Q4 기준 약 42GB가 필요해 32GB 카드 한 장으로는 느려집니다. 128GB 통합 메모리의 ASUS Ascent GX10이나 대용량 메모리 맥 스튜디오를 보세요.
MoE 모델은 메모리를 덜 먹나요? 아닙니다. 속도는 활성 파라미터로 빨라지지만, 메모리는 총 파라미터만큼 필요합니다.
로컬 LLM이면 AI 구독료가 사라지나요? 줄어들 뿐 사라지진 않습니다. 반복·민감한 일은 로컬로, 어려운 추론은 클라우드 모델로 나눠 쓰는 게 현실적입니다.
정리
로컬 LLM 장비는 VRAM이 전부입니다. 요약·번역이면 16GB, 27~35B 에이전트 입문이면 라데온 AI PRO R9700 32GB, 속도까지 원하면 RTX 5090, 70B 이상 대형 모델이면 128GB ASUS Ascent GX10입니다. 필요 메모리는 총 파라미터 ÷ 2로 먼저 계산해 보세요.